DeepSeek y Huawei van tras el verdadero poder de Nvidia: no son solo los chips, es CUDA
La colaboración en torno a Ascend y TileLang pone el foco en las herramientas que hacen útil un acelerador. El reto es construir una alternativa de software que los desarrolladores puedan adoptar.
DeepSeek y Huawei están dirigiendo su colaboración hacia una parte de la infraestructura de inteligencia artificial que suele quedar fuera de las fotografías: el software que permite aprovechar los aceleradores. Un chip puede ofrecer capacidad de cálculo, pero necesita herramientas para convertirla en trabajo útil.
El anuncio abre una discusión más interesante que una supuesta victoria sobre Nvidia. La cuestión es si una alternativa puede resultar suficientemente práctica para que los desarrolladores la adopten, la mantengan y construyan productos sobre ella. Para NexLumi, ese es el hilo que conecta Ascend, TileLang y la competencia con CUDA.
DeepSeek y Huawei profundizan su apuesta por Ascend
Según Reuters, en una información distribuida por MarketScreener, DeepSeek anunció el 30 de septiembre que colaboró con Huawei para desarrollar herramientas de programación optimizadas para Ascend. La empresa comunicó en su cuenta oficial de WeChat la apertura de infraestructura que incluye bibliotecas de cálculo y comunicación.
La misma información recoge que DeepSeek atribuyó a Huawei apoyo al desarrollo y describió una solución conjunta de supernodo con 128 chips Ascend 950. La cifra corresponde al anuncio de la compañía: no es una medición de NexLumi ni demuestra un resultado comparativo frente a Nvidia.
Hay una diferencia importante entre distribuir código y demostrar que un ecosistema completo está listo para cualquier empresa. La apertura permite examinar una implementación, probarla y proponer cambios. La decisión de utilizarla en producción exige además comprobar cómo responde ante las tareas concretas del usuario.
El problema que intenta resolver esta estrategia
La dependencia tecnológica tiene varias capas. Una organización puede necesitar un determinado procesador, pero también bibliotecas, compiladores y personal que conozca sus herramientas. Cambiar la primera pieza no sustituye automáticamente las demás.
En el contexto de las restricciones tecnológicas que condicionan el acceso chino a determinados productos, la posibilidad de desarrollar sobre otra plataforma adquiere valor estratégico. Este artículo no interpreta licencias de exportación ni da por uniforme su aplicación: el punto tecnológico es que disponer de una segunda opción requiere más que comprar chips distintos.
Pensemos en un equipo que ya tiene un servicio funcionando. Antes de migrarlo, deberá comprobar si obtiene las mismas respuestas, si el coste resulta asumible y si sus ingenieros pueden resolver los problemas que aparezcan. Una transición puede tener sentido aunque no reproduzca exactamente el diseño anterior. También puede exigir un trabajo que el anuncio comercial no deja ver.
¿Por qué CUDA es tan importante para Nvidia?
Nvidia presenta CUDA como su plataforma de computación acelerada. El toolkit reúne compilador, bibliotecas, herramientas de depuración y optimización y componentes de ejecución. Permite desarrollar aplicaciones para sus GPU y utilizar recursos desde lenguajes y frameworks conocidos.
Eso facilita tareas de aprendizaje automático, entrenamiento, inferencia y computación científica: en lugar de resolver desde cero cada operación, el desarrollador puede apoyarse en componentes existentes. El cálculo paralelo consiste, de forma simplificada, en repartir trabajo entre muchas unidades capaces de procesarlo.
Una analogía ayuda: un procesador sería el motor; el software, los controles, las piezas compatibles y los conocimientos para mantener la máquina en funcionamiento. Un motor alternativo necesita también un entorno de trabajo viable.
Análisis de NexLumi: cuanto más código, experiencia y procedimientos se acumulan alrededor de una plataforma, más elementos debe considerar quien quiere cambiarla. No significa que la migración sea imposible ni que exista una única elección válida. Significa que el precio o la velocidad de una tarjeta no resumen toda la decisión.
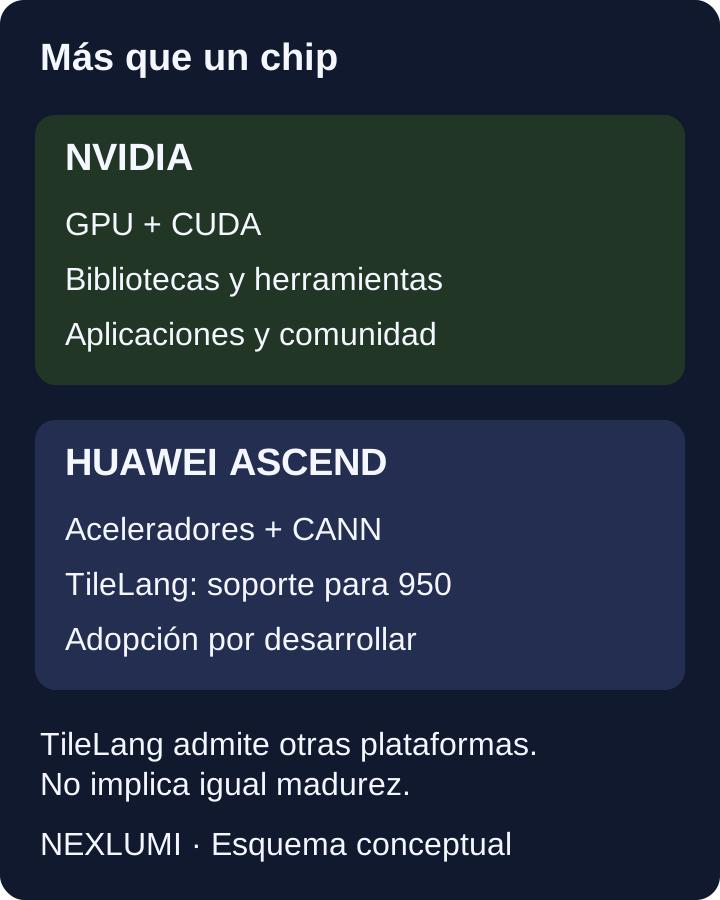
Los bloques describen funciones y estrategias. No representan igualdad de adopción, compatibilidad o rendimiento. TileLang también admite hardware Nvidia.
TileLang entra en escena
El repositorio oficial de TileLang lo define como un lenguaje especializado para desarrollar kernels de alto rendimiento. Un kernel es una rutina de cálculo que realiza una operación concreta en el acelerador. TileLang utiliza una sintaxis próxima a Python y una infraestructura de compilación apoyada en TVM.
El registro de novedades del proyecto, fechado el 30 de septiembre, anuncia soporte para Ascend 950. Su tabla de plataformas incluye además Nvidia CUDA y otros destinos. Por tanto, TileLang no es simplemente un producto exclusivo de Huawei ni un sustituto de todas las capas de CUDA.
La documentación indica que la ruta Ascend necesita CANN y torch_npu. Es una relación de componentes: el lenguaje ayuda a describir operaciones, mientras otras piezas conectan esas operaciones con el hardware y el framework.
DeepSeek sostiene, según Reuters, que TileLang simplifica la programación respecto de CUDA. Esa valoración pertenece a la compañía. Aquí no se presenta como una prueba independiente ni se ofrece un porcentaje de mejora.
Para valorar la utilidad práctica, la pregunta sería más concreta: ¿cuánto trabajo necesita un equipo para escribir, verificar y mantener la operación que realmente utiliza? Una sintaxis cómoda puede ayudar, pero no elimina por sí sola la necesidad de comprobar exactitud, compatibilidad y comportamiento bajo carga.
Ascend también necesita su propia infraestructura de software
Ascend es la familia de aceleradores de IA de Huawei, descritos como NPU o unidades de procesamiento neuronal. Su entorno incluye CANN, la arquitectura de cómputo para redes neuronales. La documentación de Ascend explica funciones como gestionar memoria y recursos, cargar modelos y ejecutar operadores.
Estas tareas son menos visibles que un chip nuevo, pero determinan cómo una aplicación lo utiliza. Una biblioteca aporta operaciones reutilizables; un framework organiza el modelo; las herramientas de diagnóstico permiten investigar qué sucede cuando el resultado o la velocidad no son los esperados.
En un comunicado del 19 de septiembre, Huawei anunció actualizaciones de Ascend C para la generación 950 y avances en herramientas de programación. Son indicaciones de la dirección de su desarrollo, no una certificación independiente de superioridad.
Desde la perspectiva editorial, trabajar simultáneamente en varias capas parece coherente con el problema que se quiere resolver. Una herramienta aislada puede ser prometedora y, aun así, necesitar integración, documentación y mantenimiento antes de convertirse en una opción cotidiana.
Ascend 950 y la estrategia de supernodos
Un supernodo agrupa aceleradores mediante una interconexión diseñada para que cooperen estrechamente. La idea puede entenderse como una sala de trabajo compartida: importa cuántos trabajadores hay, pero también cuánto tardan en intercambiar los materiales que necesitan.
Un trabajo técnico sobre CloudMatrix384, una arquitectura anterior con Ascend 910C, describe la combinación de aceleradores, procesadores e interconexión. Sirve para entender el enfoque, no para trasladar sus resultados a Ascend 950.
Cuando un modelo se reparte entre dispositivos, mover datos y sincronizar operaciones puede afectar al resultado del conjunto. Por eso conviene distinguir capacidad de cálculo de un componente y rendimiento de una aplicación completa.
La configuración anunciada este septiembre no debe confundirse con todas las variantes comerciales o planes de Huawei. Tampoco permite deducir consumo, latencia o coste a partir del número de chips. Esas preguntas necesitan datos del sistema concreto y de la carga utilizada.
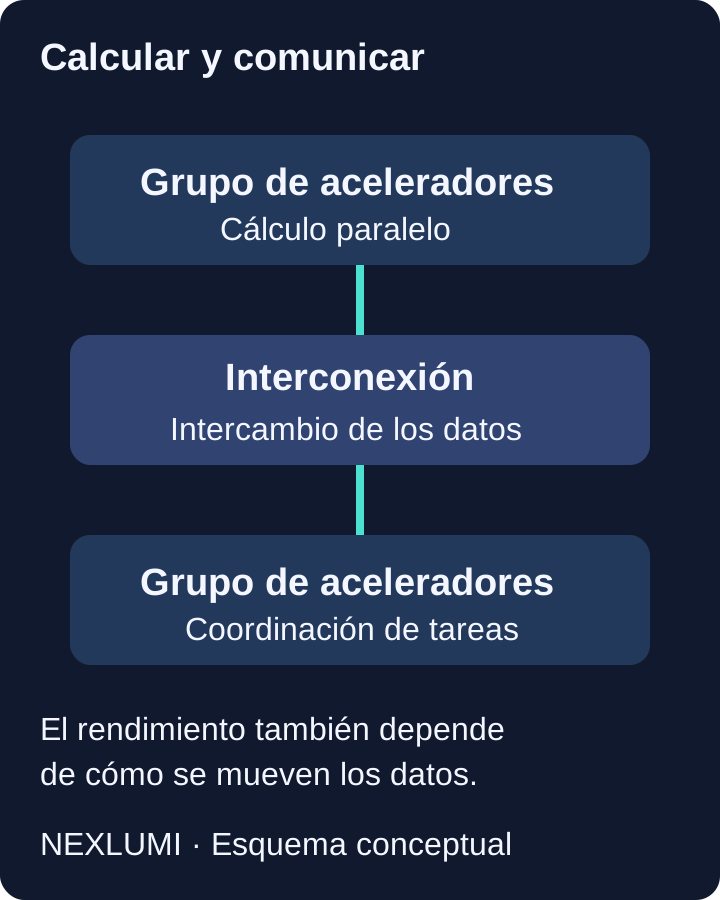
Esquema simplificado: los bloques representan grupos de recursos, no un plano de producto ni un recuento de chips. La interconexión es parte del problema de rendimiento.
¿Puede Huawei competir realmente contra Nvidia?
Puede desarrollar una propuesta alternativa; determinar en qué trabajos resulta competitiva exige pruebas. Conviene evitar dos extremos: asumir que cualquier avance cambia inmediatamente el mercado o descartarlo porque el ecosistema rival tiene más recorrido.
Análisis de NexLumi: la colaboración entre quien desarrolla modelos y quien desarrolla hardware puede ayudar a identificar necesidades concretas. El valor potencial está en ajustar las herramientas a trabajo real, no en acumular nombres de productos. Abrir componentes también ofrece a terceros una oportunidad de evaluarlos.
Las preguntas pendientes son operativas. ¿Qué modelos funcionan con la configuración disponible? ¿Qué operaciones requieren adaptación? ¿Cuánto tarda el equipo en encontrar y corregir un fallo? ¿Qué ocurre después de actualizar una dependencia? ¿Existe soporte para la versión que utiliza la empresa?
Una comparación útil tendría que declarar hardware, versiones de software, precisión numérica, tamaño de la tarea y condiciones de medición. Sin esa información, una cifra llamativa puede describir sólo un caso favorable. Este artículo no incluye benchmarks propios ni declara un ganador.
El verdadero campo de batalla es el ecosistema
Para un comprador, una plataforma no termina cuando se instala el equipo. Continúa durante las actualizaciones, los cambios de modelo y los problemas de operación. El coste de migrar incluye tiempo de ingeniería, pruebas y aprendizaje, además del hardware.
La alternativa puede ganar relevancia si hace esas tareas suficientemente previsibles. Documentar limitaciones también ayuda: saber qué no está soportado evita promesas que después se convierten en retrasos. La confianza técnica se construye con resultados reproducibles y respuestas útiles, no sólo con presentaciones.
Por eso la comunidad importa como mecanismo de trabajo: ejemplos que se mantienen, errores que se investigan y conocimiento que puede compartir otro desarrollador. No disponemos aquí de una medición comparable de adopción de ambos ecosistemas y no la sustituimos por una impresión.
Qué puede cambiar para la inteligencia artificial
Una segunda plataforma viable ampliaría las opciones de los equipos que construyen servicios de IA. Podría ofrecer más margen para elegir proveedores o repartir cargas, siempre que el esfuerzo de adaptación se justifique. Es una posibilidad, no un efecto económico demostrado por este anuncio.
También conviene separar portabilidad de uniformidad. Compartir un lenguaje de programación no obliga a que dos aceleradores se comporten igual ni garantiza que la misma optimización sea adecuada para ambos. La abstracción ayuda a organizar el trabajo; la validación sigue siendo necesaria.
El movimiento de DeepSeek y Huawei representa otro paso hacia alternativas al ecosistema Nvidia. Su impacto a largo plazo dependerá de adopción, rendimiento real, herramientas y comunidad. La pregunta que decidirá su utilidad es sencilla: ¿puede un equipo construir y mantener una aplicación fiable sobre esa plataforma con un esfuerzo razonable?
Fuentes y lectura adicional
- Reuters, distribuido por MarketScreener — alianza DeepSeek y Huawei (30 septiembre 2026)
- TileLang — repositorio oficial y soporte Ascend 950
- Nvidia — plataforma CUDA
- Huawei Ascend — documentación de CANN
- Huawei — novedades de Ascend C y herramientas (19 septiembre 2026)
- Serving Large Language Models on Huawei CloudMatrix384 — trabajo técnico
También te puede interesar
OpenAI frena un nuevo modelo por seguridad: la carrera por controlar una IA cada vez más autónoma
Los agentes pueden utilizar herramientas y ejecutar acciones. La ciberseguridad tendrá que evolucionar con ellos.